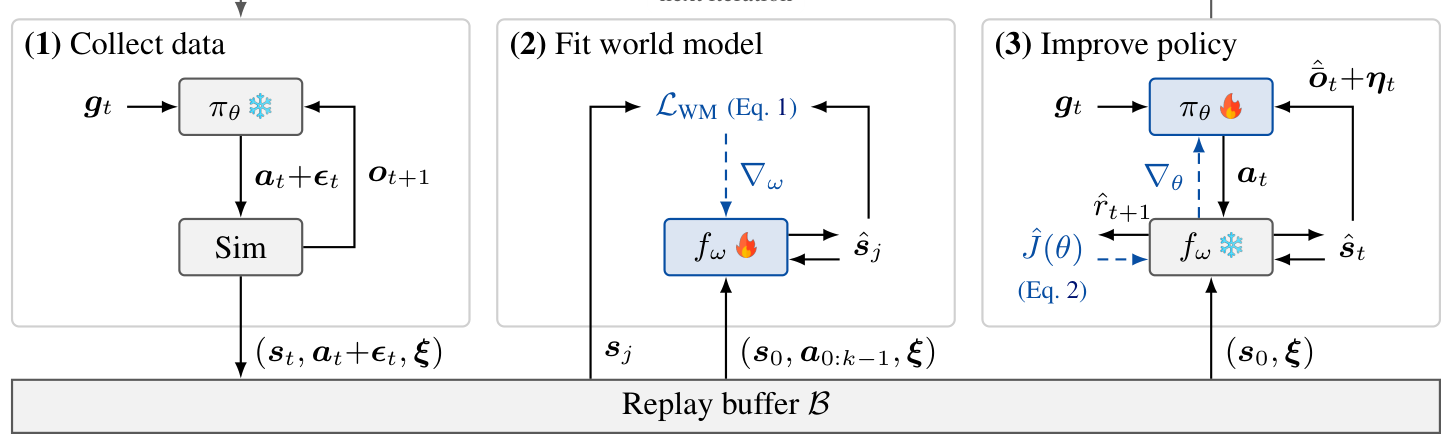
SuperMimic(UC Berkeley,CoRL 2026)用一个学出来的可微世界模型训练人形机器人的全身动作跟踪策略:单张 GPU 训练 3 小时,就超过了一个用 128 张 GPU 训练 7 天的 PPO 基线,GPU 小时少了一千倍以上。
我为这篇论文写了一份交互式的中文导读,分成两个标签页:
- 导读 · 概念 · 实现细节:论文讲了什么、读懂它需要的基础概念和符号表,以及复现时需要的全部实现细节。
- 教程:PPO、MBRL 与 SuperMimic:从策略梯度定理一路讲到 PPO 的裁剪目标;再讲基于模型的强化学习是什么、有哪几种用法、难在哪里;最后把 SuperMimic 的前向、训练顺序和反向传播完整走一遍。每一节开头都有一段”大白话”。
页面里有三百多个公式、十来张示意图和可切换的标签页,放在普通文章里没法正常排版,所以完整内容放在一个独立页面:
文中的论文图片均来自原论文 arXiv:2610.28480,版权归作者所有。