ConTrack:带在线权衡的约束式手部动作跟踪
Constrained Hand Motion Tracking with Adaptive Trade-off Control
ManipTrans 0.743(表 2)
0.899 对 0.727(表 5)
ManipTrans 0.620,DexMachina 0.708
关键方法
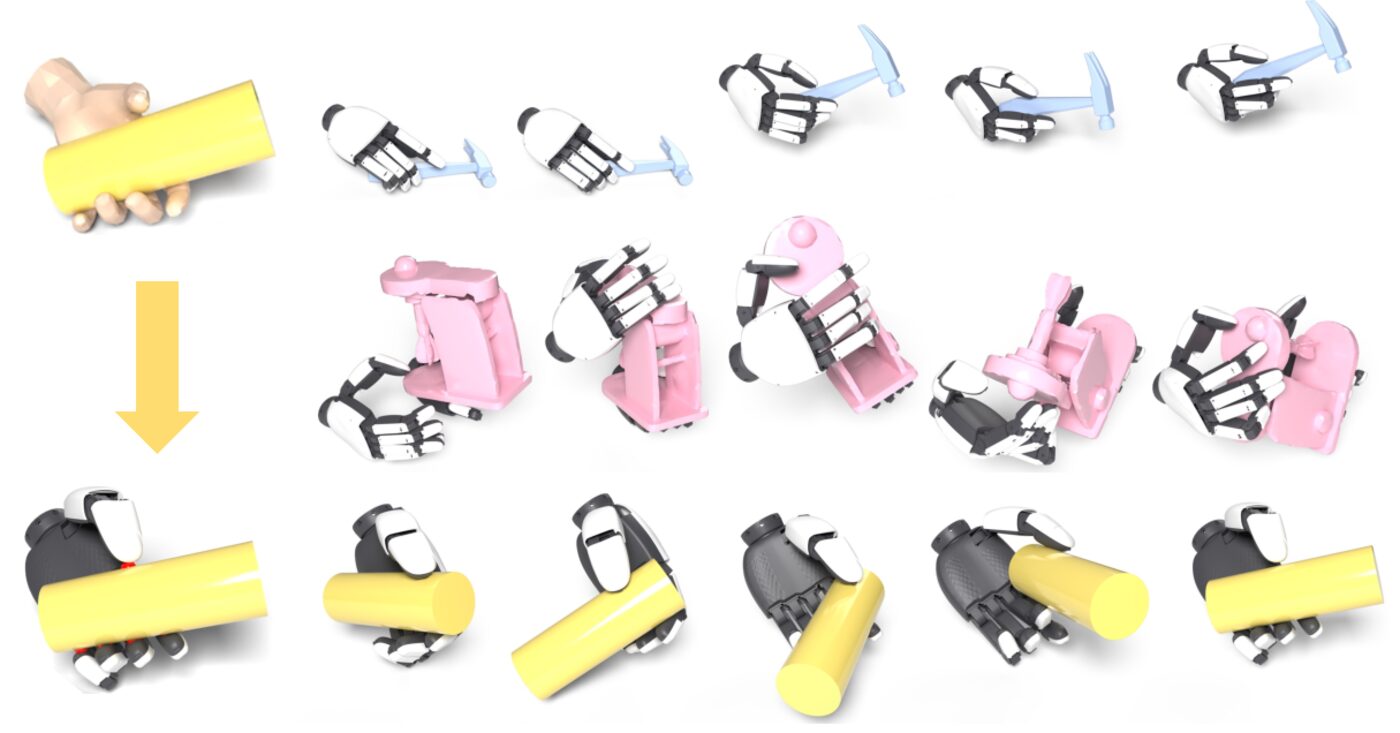
任务是让机器人手(xArm7 + XHand,单手或双手)在仿真里复现一段人手操作物体的演示。参考给出逐帧的关节轨迹(人手重定向得到)、物体位姿和手–物接触标注。策略输出关节残差,关节目标 = 参考关节 + 残差。奖励分三路:任务 \(r_g\)(物体位姿),风格 \(r_s\)(臂与手指关节、接触),惩罚 \(r_p\)(速度与加速度)。每个片段单独训练一个策略。论文
- 物体跟踪是约束,风格是目标。在任务回报不低于近期最好水平的 α 倍的前提下,最大化风格回报。一个标量对偶变量 λ 在每次 PPO 更新后按约束满足程度调整,混合权重取 \(w_{\text{task}}=\sigma(\lambda)\)。
- 重置库。参考的每一帧 k 存一个仿真状态,来源是策略自己跑到过的状态:某个回合经过第 k 帧后坚持得比以往都久,就用它覆盖。起点按存活比 \(u_k\) 采样,越常失败的帧越常被选中;另有一半概率从"失败边界"前 100 帧开始。
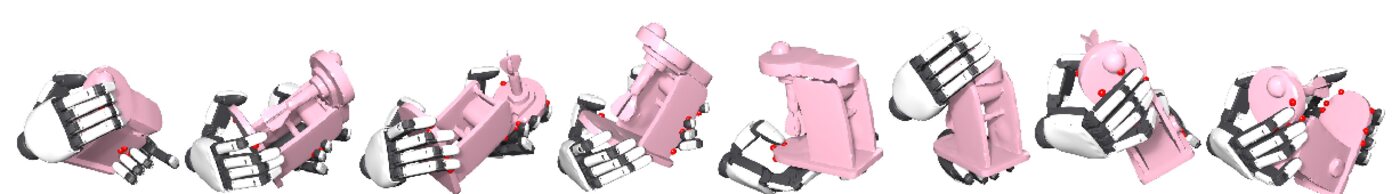
- 接触先验。把数据集的接触标注合并到 XHand 的 10 个连杆上,奖励"参考有接触时仿真也接触",并在双方都接触时奖励接触点靠近标注点。
- \(J_g,J_s\):任务、风格的折扣回报;\(\hat J_g\):任务回报的在线估计;\(J_g^\star\):\(\hat J_g\) 的近期最大值;α = 0.9,η = 0.05。
- \(A_g,A_s,A_p\):三路奖励各自的优势估计;σ:logistic 函数。
- \(\bar\ell_k\):从第 k 帧起平均还能跟多少帧(指数滑动平均);T:片段长度(动作步);τ = 1。
实验结果
| 方法 | 进度 ↑ | 物体位置 (m) ↓ | 物体旋转 (rad) ↓ | 手指误差 (rad) ↓ | 接触 F1 ↑ | 接触点 (m) ↓ |
|---|---|---|---|---|---|---|
| ConTrack | 0.899 ± 0.195 | 0.026 ± 0.006 | 0.272 ± 0.105 | 0.163 ± 0.014 | 0.784 ± 0.072 | 0.018 ± 0.005 |
| ManipTrans | 0.743 ± 0.292 | 0.012 ± 0.009 | 0.207 ± 0.078 | 0.277 ± 0.089 | 0.620 ± 0.068 | 0.030 ± 0.010 |
| DexMachina | 0.246 ± 0.052 | 0.038 ± 0.018 | 0.348 ± 0.121 | 0.147 ± 0.016 | 0.708 ± 0.041 | 0.024 ± 0.003 |
| SPIDER | 0.444 ± 0.341 | 0.201 ± 0.113 | 1.104 ± 0.599 | 0.157 ± 0.019 | 0.191 ± 0.225 | 0.036 ± 0.011 |
论文表 2。13 个片段(GRAB 5、ARCTIC 4、DexterHand 4)的均值 ± 标准差,每片段 5000 次 PPO 更新。评估一律从第一帧开始,物体平移误差超过 0.10 m 或旋转误差超过 1.00 rad 即终止;进度 = 终止帧 / (T − 1)。蓝色为各列最好。ManipTrans 为作者重新实现,DexMachina 只移植了其虚拟物体控制器。论文
- 分层。GRAB 平均进度 0.996,ARCTIC 0.944,DexterHand 0.733。最难的 DexterHand Ring 只有 0.272;训练延长到 100,000 次更新后成功率 94%。表 3附录 G
- 对偶权重。自适应 0.899,固定 1:1 为 0.868,只用任务为 0.764;接触 F1 分别为 0.784、0.701、0.679。扫描 α 得到一条进度–接触 F1 前沿,固定权重的点都在前沿内侧(全程第 6 步重绘了图 4)。表 4图 4
- 接触先验。去掉接触事件奖励,进度 0.861、F1 0.699;去掉接触距离奖励,进度 0.868、接触点误差 0.023 m。表 6
- 其他手与真机。Sharpa Wave 手平均进度 0.929。真机是双臂 xArm7 + XHand:策略在仿真里运行,算出的关节参考经 TCP 发给实时控制器,参考每 0.15 s 更新,臂内环 250 Hz。表 74.7 节
结论
- 约束式表述把"物体必须跟上"和"手要像人"分开。α 是唯一需要人调的旋钮,同预算下固定权重被前沿支配。
- 重置方式对进度影响最大。重置库比均匀中途重置高 0.172,对偶权重比固定 1:1 高 0.031(两者来自不同消融表,只比量级)。
- 局限。约束按滑动最大值归一化,不保证严格满足;依赖接触标注;最难的手内旋转片段在预算内仍不稳;真机只执行关节指令,没有感知闭环。第 5 节
- 代码与论文有十余处不一致,包括库的写入规则、执行器的观测和训练时长,列在全程第 9 节。
基础:读懂 ConTrack 需要的背景
四件事:参考跟踪是怎样的 MDP,PPO 的核心,约束强化学习与对偶变量,以及"每个回合从哪里开始"的几种做法。公式编号用 (B·)。
1. 参考动作跟踪是一个怎样的 MDP
一段参考片段长 T 个控制步。仿真的物理状态 \(x_t\) 包括机器人关节角和角速度、物体位姿和速度。参考在每一帧给出关节目标 \(q^{\text{ref}}_t\in\mathbb R^D\)(D 是驱动关节数)、每个物体的位置 \(p^{\text{ref}}_{t,o}\in\mathbb R^3\) 和单位四元数 \(\bar q^{\text{ref}}_{t,o}\),以及每个手部连杆 ℓ 与物体 o 的接触标注 \(c^{\text{ref}}_{t,o,\ell}\in\{0,1\}\)。ConTrack 把帧号并进状态:论文 3.1
帧号必须属于状态:同一个物理状态,在第 10 帧和第 200 帧该做的动作不同。这也是"从中途开始"成立的前提:把仿真设成某个状态、把帧号设成 k,就得到一个合法的起点。
动作是参考关节上的残差 \(a_t\):
残差参数化让刚初始化的策略也大致贴着参考运动,探索只发生在参考附近。目标是折扣回报,γ ∈ (0, 1] 是折扣因子:
回合在两种情况下结束:物体偏离参考超过阈值(ConTrack 评估用 0.10 m 和 1.00 rad),或到达最后一帧。前一种终止让"能跟多远"成了天然的难度信号:回合在哪里断,哪一段就难。
2. PPO 的核心
PPO 是在线策略梯度方法。每次迭代先用当前策略在 N 个并行环境里各跑 H 步(ConTrack 的 H = 16),再用这批数据估计优势,做若干轮小批量梯度更新,然后丢掉数据。优势 \(\hat A_t\) 回答"这一步的动作比这个状态下的平均水平好多少"。用 critic \(V\) 估计状态价值,先算一步的 TD 残差(\(d_{t+1}=1\) 表示第 t 步之后回合结束):
再把后续各步的残差按 \((\gamma\lambda_{\text{GAE}})^l\) 衰减相加,得到广义优势估计(GAE)。为了不和后面的对偶变量 λ 混淆,GAE 的参数写成 \(\lambda_{\text{GAE}}\):
策略更新用裁剪目标。\(\rho_t=\pi_\theta(a_t\mid s_t)/\pi_{\text{old}}(a_t\mid s_t)\) 是新旧策略的概率比,ε 是裁剪范围:
裁剪让每次更新后的策略不离开采样时的策略太远,于是同一批数据可以反复用几轮。ConTrack 的设置:γ = 0.99,\(\lambda_{\text{GAE}}\) = 0.95,ε = 0.2,每次更新 10 轮、每轮 16 个小批量,按 KL 自适应调学习率(目标 KL 0.01)。代码 xhand/agents/rsl_rl_ppo_cfg.py:39-58
2′. 多路奖励的优势
(B4)(B5) 对奖励和价值都是线性的。若奖励是两路之和 \(r=r^{(1)}+r^{(2)}\),critic 也输出两个值且 \(V=V^{(1)}+V^{(2)}\),那么两路分别算出的优势相加,就等于总奖励的优势:
所以可以先分别估计各路优势,再用随时变化的权重组合,效果等同于"按这个权重重新加权奖励",不必重算 GAE。ConTrack 就是这样在线改权重的。有一个前提:若每一路在组合前先各自标准化(减均值、除标准差),(B7) 不再成立,权重作用在标准化之后的量上。ConTrack 的代码属于这种情况,见全程第 6 步。
3. 约束强化学习与对偶变量
约束 MDP(CMDP)在一个回报上加约束,优化另一个回报。c 是约束的下限:
拉格朗日松弛把约束搬进目标,乘子 \(\mu\ge 0\):
求解是一个鞍点问题:策略对 \(\mathcal L\) 做上升,乘子对 \(\mathcal L\) 做下降。\(\mathcal L\) 对 μ 的导数是 \(J_g-c\),所以乘子沿 \(c-J_g\) 方向走,η 是步长,并截断在非负区间:
读法:约束没满足(\(J_g\lt c\))时 μ 增大,任务回报在目标里的分量变重;约束满足且有余量时 μ 减小,把优化压力还给风格。μ 相当于约束的价格。RCPO(Tessler 等 2018)等方法用的就是这种原始–对偶更新,论文引用了它们。论文 2、3.2
ConTrack 在这套框架上改了两处:
- 归一化的约束。取 \(c=\alpha J_g^\star\),\(J_g^\star\) 是任务回报估计的近期最大值。比值 \(\hat J_g/J_g^\star\) 没有量纲,同一个 α 可以用在任务回报尺度不同的片段上。
- 用 sigmoid 把对偶状态变成凸组合权重。对偶状态 λ 取任意实数,混合权重 \(w=\sigma(\lambda)\in(0,1)\),任务和风格按 \(w\) 与 \(1-w\) 组合。
推导:按 σ(λ) 混合,等价于乘子 μ = eλ 的拉格朗日目标
这一段是本文的推导,论文没有这样写。推断 利用 \(\sigma(\lambda)/(1-\sigma(\lambda))=e^\lambda\):
正的因子 \(1-\sigma(\lambda)\) 不改变最大值点(对策略梯度只是缩放步长),常数项 \(-\mu c\) 与策略无关,所以按 \(w=\sigma(\lambda)\) 混合,与乘子取 \(\mu=e^\lambda\) 的 (B9) 有相同的最优策略。两个推论:
- μ 自动为正,不需要 (B10) 的截断。
- λ 的加法更新就是 μ 的乘法更新:\(\mu\leftarrow\mu\cdot\exp\big(\eta(\alpha-\hat J_g/J_g^\star)\big)\)。
数值例子。η = 0.05、α = 0.9 时,若比值一直停在 0.8,λ 每次更新增加 0.005,1000 次后 λ = 5,\(w=\sigma(5)\approx 0.993\),几乎只优化任务。若比值停在 1.0,λ 每次减少 0.005。
4. 重置策略:每个回合从哪里开始
片段长、失败早时,从第一帧开始的回合大多在前几十帧就终止,后面的接触阶段几乎采不到样本,学习信号也要跨很长的时间才能传回前面。重置策略决定训练样本在片段上的分布。常见做法:
| 做法 | 起点状态 | 起点帧怎样选 | 代表 | 问题 |
|---|---|---|---|---|
| 总从第一帧 | 参考第 0 帧 | 只有 0 | 与评估协议相同 | 后段样本少,早期失败主导数据 |
| 均匀中途重置 | 参考第 k 帧 | k 均匀 | DeepMimic 的参考状态初始化 | 已学会的段落占同样多的样本;手物交互中参考状态可能不可实现 |
| 按难度重置 | 参考第 k 帧 | 按各段失败率加权 | BeyondMimic、SONIC 的自适应采样 | 参考状态的问题仍在;要防止全部集中到最难的段 |
| 课程式后移 | 演示中的状态 | 先靠近末尾,逐渐前移 | Backplay | 需要规定前移的节奏 |
| 从到达过的状态重置 | 策略自己跑到过的仿真状态 | 按难度加权 | Go-Explore 的存档思路;ConTrack | 只能从跑到过的地方开始;库的内容随策略变化 |
4′. 为什么手物交互不能直接把仿真设成参考状态
人形跟踪里,参考帧可以直接写进仿真:关节角、根部位姿、速度写进去,机器人站在地上,物理上基本一致。手物交互的参考帧不行,原因有三:
- 几何不一致。参考关节来自人手到机器人手的重定向,物体位姿来自人手的动捕。机器人手指和人手形状不同,同一帧里机器人手指可能穿进物体,也可能离物体还有几毫米。
- 力不在状态里。抓稳物体靠接触力平衡重力。仿真状态只有位置和速度,写入的那一刻接触力为零,要由求解器在下一步重新算出。穿透会被很大的冲量推开,悬空的物体会直接下落。
- 速度是差分出来的。参考速度来自相邻帧的有限差分,不一定满足接触约束。
论文的表述是:这类重置可能在物理上不一致,因为接触构型在仿真动力学下不一定可实现,会产生无法挽回的起点。论文 2、3.3
两种应对:在参考状态上加临时辅助(例如开头给物体一个托住它的外力,再在短时间内撤掉),或者只从策略自己跑到过的状态开始(ConTrack 的做法,见全程第 3 步)。后者的状态一定是仿真可实现的;代价是库的内容取决于当前策略,而且第 0 帧和尚未到达的帧仍只能用参考状态。代码
4″. 训练重置与评估是两回事
训练时的起点分布只为让样本更有用。评估回答"从头跑能跟多远",所以 ConTrack 评估一律从第一帧开始。设 τ 为终止帧,进度定义为:论文 4.2
重置库越把训练集中到中后段,越需要保证"从第 0 帧的参考状态出发"这一种起点也被练到。全程第 4 步会算出它在代码里得到的份额。
ConTrack 全程
按开源代码(提交 f5efe18)把一次训练从准备到评估走一遍,以 XHand 版为主。路径前缀 source/ConTrack/ConTrack/tasks/manager_based/mimic_xarm_xhand/ 简写为 xhand/,PPO 在 rsl_rl_contrack/。每一步给出整体流程、关键公式(编号 C·)和从代码提取的伪代码。论文和代码说法不同的地方集中在第 9 节。
ManagerBasedRLEnv.step:物理、终止、奖励、reset 事件、interval 事件、观测;ConTrack 把写库放在 reset 事件、把推进帧号放在 interval 事件里。代码 xhand/xarm_xhand_env_cfg.py:503-524本页用到的常数(XHand 与 Sharpa 相同)
- 重置库:
DELTA = 100,EMA_ALPHA = 0.05,HARD_RESET_TOPK = 64,EPSILON_GREEDY = 0.5,TAU = 1.0xhand/mdp/state.py:33-37 - 对偶权重:α = 0.9,η = 0.05,λ 初值 0,\(\hat J_g\) 窗口 100 个回合,\(J_g^\star\) 窗口 20 次更新,预热 0 次
xhand/agents/rsl_rl_ppo_cfg.py:52-57 - 时间:仿真步长 1/120 s,每个控制步 2 个子步,控制频率 60 Hz;每次更新每个环境 16 步
xhand/xarm_xhand_env_cfg.py:46-47,rsl_rl_ppo_cfg.py:26
第 0 步:准备参考数据,库的每一帧先填参考状态
xhand/mdp/state.py:40-129(读取),:132-176(缓存),:179-373(准备)
整体流程
- 读 HDF5:每只手 19 个关节(xArm 7 + XHand 12)的轨迹,每个物体的平移和 xyzw 四元数(转成 wxyz),每个物体对 15 个手部段的接触标志和物体局部接触点;缺失的接触点(NaN)置 0。
- 15 段合并为 10 个连杆:连杆接触取所含各段接触的"或",连杆接触点取接触段的点的平均(附录 E 式 14)。
:96-119 - 四元数符号连续化:相邻帧点积为负就翻号。
:153-159 - 重采样到控制频率:关节和物体位置线性插值,四元数线性插值后归一化,接触标签取最近帧。
:220-245 - 用有限差分算参考速度,拼成每帧的参考状态,作为库的初值;续航统计清零。
:247-317
关键公式
- \(T_{\text{raw}},f_{\text{raw}}\):原始帧数和帧率;T:重采样后的长度,之后所有"帧"都指控制步。
- (C2) 首尾两帧用单侧差分。\(\omega_t\) 是物体角速度,由前后两帧的相对旋转换成旋转向量。
- \(B[k]\):库中第 k 帧的状态;\(x^{\text{ref}}_k\):参考关节角与 (C2) 的速度、参考物体位姿与速度拼成的状态。
- \(\bar\ell_k\):第 k 帧的平均续航;\(\ell^{\max}_k\):第 k 帧的最佳续航(第 3 步定义)。
# xhand/mdp/state.py: prepare_reference_state(提取)
ref = load_reference(h5)                          # 40-129:15 段 → 10 连杆,NaN → 0
ref.quat = make_sign_continuous(ref.quat)         # 153-159
T = floor((T_raw - 1) * f_act / f_raw) + 1        # 220-223,(C1)
q_ref, p_ref = lerp(ref, T);  quat_ref = nlerp(ref.quat, T)
contact_ref = nearest(ref.contact, T)             # 237-239
hand_vel, obj_vel, obj_angvel = central_diff(...) # 247-288,(C2)
B[0:T]   = concat(q_ref, hand_vel, p_ref, quat_ref, obj_vel, obj_angvel)   # 290-295,(C3)
ell_bar[0:T] = 0;  ell_max[0:T] = 0                # 296-299
eps_pos, eps_rot = 0.10, 1.0                      # 359-370:终止阈值的初值
这一步决定了库的一个事实:每一帧在被访问之前都是参考状态,第 0 帧永远是参考状态(第 3 步解释为什么)。论文没有提到库的初值。代码
第 1 步:一个控制步
xhand/mdp/actions.py:266-291,xhand/mdp/terminations.py:6-51,xhand/mdp/rewards.py,xhand/mdp/state.py:469-494
整体流程
- 动作截到 [−1, 1],乘以缩放后加到第 f 帧的参考关节上,作为 PD 目标。
- 物理推进 2 个子步。
- 终止判断:到达最后一帧(时间到),或任一物体的平移或旋转误差超过当前阈值(失败)。
- 奖励:所有项都和第 f 帧的参考比较(第 7 步)。
- 结束的环境进入 reset 事件(第 3、4 步);其余环境进入 interval 事件(第 2 步)。
关键公式
训练时阈值不是固定的。每批结束的回合里到达末帧的比例记为 SR,做滑动平均后线性插值出阈值:代码 xhand/mdp/state.py:469-494,xarm_xhand_env_cfg.py:84-90, 605-614
- f:当前帧号;s:逐关节的动作缩放(
ACTION_SCALE,xarm_xhand_env_cfg.py:50);⊙:逐元素乘。 - \(\varepsilon_p,\varepsilon_\theta\):平移、旋转阈值。成功率接近 0.999 时收紧到 0.05 m、0.5 rad。论文只给出评估阈值 0.10 m、1.00 rad,没有提到训练时的阈值课程。
# 一个控制步(顺序由 IsaacLab ManagerBasedRLEnv.step 决定)
q_tar = q_ref[f] + scale * clip(a, -1, 1)          # actions.py:280-287,(C4)
for _ in range(2): physics_step(dt=1/120)
time_out = f >= T - 1                              # terminations.py:38-51
failed   = any(pos_err > eps_pos or rot_err > eps_rot)   # terminations.py:6-35,(C5)
r_g, r_s, r_p = rewards_against(ref[f])            # 第 7 步
reset_event(envs where time_out or failed)         # state.py:394,第 3、4 步
interval_event(all other envs)                     # state.py:658,第 2 步
obs = observe(f)                                   # 第 7 步
第 2 步:记录每个环境走过的状态
xhand/mdp/state.py:658-731(advance_reference_frame)
整体流程
没有结束的环境,在这一步的物理推进之后,把当前仿真状态写进它自己的回合缓冲区,位置是"当前帧号 − 起点帧号",并标记这一格已写;然后记下关节和物体的速度(下一步的加速度惩罚要用),帧号加一,最多到 T − 1。
- \(E_e\):环境 e 的回合缓冲区(按偏移存状态);\(k^{\text{start}}_e\):本回合的起点帧;\(x_e\):当前仿真状态。
- 存的内容:每只手 19 个关节的角度和角速度;每个物体的位置(减去环境原点)、四元数、线速度、角速度。没有存 PD 目标、接触力和"上一步速度"。
# xhand/mdp/state.py: advance_reference_frame(提取)
for e in envs_not_reset:                            # 674
    x = concat(joint_pos, joint_vel, obj_pos - origin, obj_quat, obj_linvel, obj_angvel)   # 677-702
    E[e][f[e] - start[e]] = x;  filled[e][f[e] - start[e]] = True                        # 703-705
    prev_vel[e] = current_vel[e]                                                         # 707-726
    f[e] = min(f[e] + 1, T - 1)                                                          # 728-731
库里第 k 帧存的是什么时刻的状态。由这个顺序可知,第 k 帧对应的是"跟踪第 k 帧这一步结束后"的仿真状态。环境被重置到 \(B[k]\) 时帧号设为 k,下一步再次跟踪第 k 帧。这和从参考第 0 帧出发的约定一致:初始状态就是参考第 0 帧,第一步跟踪的也是第 0 帧。代码
第 3 步:重置库的写入
xhand/mdp/state.py:436-548(reset_reference_episode 的前半)
整体流程
每当有环境结束(reset 事件),对这一批结束的环境:
- 把终止时的状态写进回合缓冲区的最后一格(偏移 = 终止帧 − 起点帧)。
:436-468 - 更新训练阈值课程 (C6),累计终止帧直方图。
:469-497 - 把每个回合展开成"(帧 k, 续航 ℓ)"对,只保留缓冲区里写过的格。
:498-513 - 更新每帧的平均续航:先对这一批中经过第 k 帧的所有回合求 ℓ 的平均,再做一次指数滑动平均。没被经过的帧不变。
:514-521 - 所有帧的最佳续航乘以 0.99999。
:522 - 第 k 帧(k ≠ 0)若有回合的 ℓ 超过最佳续航,就用该回合在第 k 帧的状态覆盖库,并更新最佳续航;同一批里有多个回合打破同一帧的纪录时,取 ℓ 最大的那个。
:523-548
关键公式
- \(t_s,t_e\):回合的起点帧和终止帧;\(\ell_k\):从第 k 帧到回合结束经历的帧数(含两端),称为续航。
- \(\mathcal E_k\):这一批结束的回合中经过第 k 帧的回合集合;\(e^*\):其中 ℓ 最大的回合;\(x^{(e)}_k\):回合 e 在第 k 帧的状态(第 2 步存的)。
- 到达末帧的回合 \(t_e=T-1\),所以 \(\ell_k\le T-k\)。
# xhand/mdp/state.py: reset_reference_episode,写入部分(提取)
for e in ended_envs with a valid episode:                         # 436
    E[e][end[e] - start[e]] = current_state(e)                     # 464-468:终止状态
update_threshold_curriculum(success = end == T - 1)               # 469-494,(C6)
pairs = [(k, e, end[e] - k + 1) for e in ended                    # 498-513,(C8)
         for k in range(start[e], end[e] + 1) if filled[e][k - start[e]]]
for k in frames_in(pairs):                                        # 514-521,(C9)
    ell_bar[k] = 0.95 * ell_bar[k] + 0.05 * mean(l for (k', _, l) in pairs if k' == k)
ell_max *= 0.99999                                                # 522
better = [(k, e, l) for (k, e, l) in pairs if k != 0 and l > ell_max[k]]   # 523-530
for k, e, l in longest_per_frame(better):                         # 531-546
    B[k] = E[e][k - start[e]];  ell_max[k] = l                    # 547-548,(C10)
要点
- 每帧存什么。一个完整的可写回状态:每只手 19 个关节的角度与角速度,每个物体的位姿与线、角速度(Sharpa 版每只手 29 个关节)。论文写的是"机器人关节与速度、物体位姿与速度",一致。论文 3.3代码
- 什么时候覆盖。ℓ 严格大于(衰减后的)最佳续航时。论文算法 2 是"ℓ > ℓmax"且 ℓmax 是不衰减的运行最大值;代码每次调用乘 0.99999。按每个控制步调用一次估算,5000 次更新共 8 万步,衰减到 0.9999980000 ≈ 0.45,旧纪录会逐渐失效。推算(reset 事件在任一环境结束的步上触发;几千个并行环境下几乎每步都有环境结束。)
- 平均续航的粒度。算法 2 对每个结束的回合各做一次滑动平均;代码对同一批里经过同一帧的回合先求平均,再做一次滑动平均。并行环境多时,两者的有效平滑窗口不同。
- 第 0 帧永不覆盖(
frames != 0,:523),始终是参考状态。评估正是从这一帧开始。 - 未访问的帧。库里仍是第 0 步填入的参考状态,\(\bar\ell_k=0\)、\(\ell^{\max}_k=0\)。第一次被经过时任何 ℓ ≥ 1 都大于 0,所以第一次就会覆盖,哪怕那是一个刚触发终止的状态(ℓ = 1)。之后更长的续航会再覆盖它。
- 没有"库为空"的情况。库从一开始就填满(参考状态),所以论文里"库为空"的问题在代码里不存在;论文也没有说明初值。
第 4 步:起点采样,写回仿真
xhand/mdp/state.py:550-597(reset_reference_episode 的后半)
整体流程
- 对 k = 0, …, T − 2 计算存活比 \(u_k\)。
:550-554 - 算向后差分 \(g_k=u_{k+1}-u_k\),取最大的 64 个位置作为"边界候选";若第 0 帧不在其中,用它替换第 64 个。
:555-560 - 每个要重置的环境:先按软分支采样一个起点;再以 0.5 的概率改用硬分支,即从 64 个候选里均匀取一个,前移 100 帧,小于 0 时取 0。
:561-567 - 把 \(B[k]\) 写进仿真:手的关节角与角速度、物体的 13 维状态(加回环境原点);帧号设为 k;用所存速度初始化"上一步速度";清空并重置回合缓冲区,第 0 格先放起点状态。
:569-597
关键公式
- \(u_k\):存活比,从第 k 帧出发平均能跟完剩余长度的几成;越小越难。
- \(\mathcal K\):边界候选集合,固定 64 个元素(第 0 帧必在其中,必要时挤掉第 64 名)。
- 前移 100 帧在 60 Hz 下约 1.67 s。
# xhand/mdp/state.py: reset_reference_episode,采样部分(提取)
u = ell_bar[0:T-1] / (T - arange(T-1))               # 550-554,(C11)
g = zeros_like(u);  g[:-1] = u[1:] - u[:-1]          # 555-556
K = topk(g, 64).indices                              # 557-558
if 0 not in K: K[-1] = 0                             # 559-560
k = multinomial(softmax(-u / 1.0), n)                # 561,(C12)
hard = rand(n) < 0.5                                 # 562
k[hard] = clamp(K[randint(64)] - 100, min=0)         # 563-567,(C13)
write_to_sim(B[k]);  f = k                           # 570-591
E[:, 0] = B[k];  filled[:, 0] = True;  start = k     # 593-597
torch.topk 的实现决定,图中未画。软分支几乎是平的,最大与最小权重之比约 2.5。要点
- p(k) ∝ exp(−uk/τ) 的集中程度有上界。因为 \(u_k\in[0,1]\),任意两帧的软分支权重之比不超过 \(e^{1/\tau}=e\approx 2.72\)。推导 用论文图 5 的曲线代入,1000 次更新时这个比是 2.2,5000 次时是 1.32。推算 所以软分支接近均匀,起点的集中主要来自硬分支。
- top-64 是怎么选的。选的是 \(g_k\) 最大的 64 个位置,即"从 k 出发很快失败,从 k+1 出发却能跟得远"的地方,失败点就在 k 附近;再前移 100 帧,让策略带着前面积累的状态进入这一段。论文附录 D 写的是"\(u_k\) 变化最剧烈的 64 处",没有说明只取正向跳升。代码附录 D
- 名额总是取满 64 个。真正的边界不足 64 处时,其余名额由较小的正差分补满,包括已学会区域里 \(u\approx 1\) 附近的统计起伏。推断
- 第 0 帧的份额。第 0 帧总在候选里,硬分支至少给它 0.5/64 ≈ 0.78%;所有 \(k^*\lt 100\) 的候选也被截到 0;再加上软分支的份额。按图 5 曲线推算,1000 次更新时约 1.7%,3000 次以后约 10%。推算
- 防止过度集中。代码没有显式机制(例如与均匀分布混合或设上限)。软分支本身接近均匀,硬分支分散在 64 个候选上,两者起到了这个作用。推断
- 不加噪声。写回时不扰动状态;物体 xy 扰动和 PD 增益随机化默认关闭(范围 0 与 1.0)。代码
xarm_xhand_env_cfg.py:54-56 - 最后一帧不会被选为起点(只对 k ≤ T − 2 采样)。
第 5 步:库在训练中的演化
论文 4.6 节与图 5;日志 scripts/rsl_rl/train.py:556-650
- 图 5 画的是 \(u_k\),不是起点分布。第 0 帧的存活比从 0.25(1000 次)升到 0.50、0.63、0.69、0.83(5000 次);约第 180 帧附近一直有一个低谷(1000 次时 0.21,5000 次时 0.72);第 500 帧以后接近 1。图 5
- 是哪个片段。横轴到第 597 帧,按 60 Hz 约 10 s,与表 1 里唯一 10 秒的 ARCTIC mixer_use 一致。论文没有注明。推断
- 论文的描述。"训练早期重置集中在片段末尾,随着可达的后缀变长,重置前移。"论文 4.6 图 5 从 1000 次更新开始画,看不到更早的阶段;按 (b) 的推算,1000 次时起点约 69% 已落在前 300 帧,之后第 0–200 帧的份额从约 41% 升到 50% 以上。代码把每个日志区间的起点直方图写到
reset_library/reset_index(train.py:610-650),论文没有展示这张图。推算 - 续训。库的全部张量存进检查点,续训时恢复(
train.py:687-695)。
第 6 步:两路优势与任务–风格的在线权衡
rsl_rl_contrack/algorithms/ppo.py,rsl_rl_contrack/env/cons_mimic_reward_wrapper.py:129-158,rsl_rl_contrack/storage/rollout_storage.py:134-157
约束 MDP、拉格朗日乘子和 σ(λ) 的含义见基础第 3 节。
整体流程
- 奖励分组:\(r_g\) = 物体位置 + 物体旋转;\(r_s\) = 臂关节 + 手指关节 + 接触事件 + 接触距离;\(r_p\) = 8 项速度与加速度惩罚。包装器按组求和并乘以控制步长 dt。
xarm_xhand_env_cfg.py:615-633,wrapper:130-134 - 每步存两路奖励 \((r_g+r_p,\ r_s+r_p)\);critic 输出两个值;两路各做 GAE,并各自标准化。
ppo.py:194,modules/actor_critic.py:69,rollout_storage.py:134-157 - 每个回合结束时,把该回合 \(r_g\) 的累加值放进长度 100 的队列。
ppo.py:183-190 - 更新开始:\(w=\sigma(\lambda)\);\(\hat J_g\) = 队列均值,放进长度 20 的队列,\(J_g^\star\) = 该队列最大值。
ppo.py:231-242 - 小批量更新:用混合优势算裁剪目标,两个价值头一起回归。
ppo.py:338-356 - 更新结束:按 (C16) 更新 λ。
ppo.py:449-455
关键公式
- \(\hat A[\cdot]\):对括号内奖励做 GAE 得到的优势;norm:在整批数据上减均值、除标准差,两路分别做。
- (C14) 与论文式 (5) 的关系:若不标准化,下式成立,两者相同(基础页 (B7));代码先标准化再混合,等式不再严格成立。\[w(A_g+A_p)+(1-w)(A_s+A_p)=wA_g+(1-w)A_s+A_p\tag{C14′}\]
- (C15) 里 \(r_{g,t}\) 已乘 dt,求和不打折扣。
# rsl_rl_contrack/algorithms/ppo.py(提取)
process_env_step:                                         # 175-212
    ep_rg += r_g;  for done e: vg_buffer.append(ep_rg[e]); ep_rg[e] = 0   # 183-190
    store reward = (r_g + r_p, r_s + r_p)                  # 194
compute_returns: GAE per channel, then normalize per channel   # storage 134-157
update:
    n_updates += 1
    if n_updates <= warmup:   lam = 20.0;  w = 1.0           # 231-233,默认 warmup = 0
    elif n_updates == warmup + 1:  lam = lam_init;  w = sigmoid(lam)   # 234-236
    else:                     w = sigmoid(lam)              # 237-238
    vg_hat = mean(vg_buffer);  vg_hat_buf.append(vg_hat);  vg_star = max(vg_hat_buf)   # 240-242
    for minibatch: A = w * A[...,0] + (1 - w) * A[...,1];  PPO clipped loss   # 340-356
    if n_updates > warmup: lam += 0.05 * (0.9 - vg_hat / (vg_star + 1e-8))      # 449-455,(C16)
第 232 行 lambda_raw.fill_(20.0) 在什么条件下触发
- 条件是
self.num_updates <= self.cmdp_warmup_iters。num_updates在每次update()开头加一,从 1 开始。 - 默认不触发。
cmdp_warmup_iters在构造函数(ppo.py:46)和配置(rsl_rl_ppo_cfg.py:18, 54)里都是 0,而num_updates至少为 1,条件不成立。XHand 和 Sharpa 的配置相同;README 的训练命令没有改它(train.py通过 Hydra 接受配置覆盖,train.py:88, 130, 281,所以用户可以手动打开)。 - 若设为 N > 0:前 N 次更新 λ 被置为 20(σ(20) ≈ 1 − 2×10⁻⁹),本次直接取 w = 1.0,只优化"任务 + 惩罚"那一路;λ 不更新(
:449条件不成立),但 \(\hat J_g\)、\(J_g^\star\) 照常统计。第 N + 1 次更新把 λ 重置为cmdp_lambda_init(默认 0),之后正常更新。 - 续训时 λ 从检查点恢复(
runners/on_policy_runner.py:401-402)。 - 论文没有提到这个预热选项。
要点
- λ 下降慢、上升快。\(J_g^\star\) 是包含当前 \(\hat J_g\) 的窗口最大值,所以比值 ≤ 1,λ 每次最多下降 η(1 − α) = 0.005,最多上升 ηα = 0.045。推导
- \(\hat J_g\) 受起点分布影响。它是不打折扣的回合累计,回合从不同帧开始、长度不同。重置库让起点前移、回合变长时,\(\hat J_g\) 会随之上升,这部分变化与策略好坏无关。推断
- 窗口最大值只看最近 20 次更新。任务回报缓慢下降时 \(J_g^\star\) 跟着下降,比值仍可接近 1,约束察觉不到这种漂移。论文在局限里承认约束不保证严格满足。推断第 5 节
- 论文内部的不一致。算法 1 第 4 行写 \(J_g^\star\leftarrow\max\{J_g^\star,\hat J_g\}\)(全程最大值),附录 D 写"最近 20 次更新的最大值";代码与附录一致。算法 1 第 3 行说用折扣回报,代码不打折扣。
| 变体(论文表 4) | 进度 ↑ | 物体位置 (m) ↓ | 物体旋转 (rad) ↓ | 手指误差 (rad) ↓ | 接触 F1 ↑ | 接触点 (m) ↓ |
|---|---|---|---|---|---|---|
| 自适应(ConTrack) | 0.899 ± 0.195 | 0.026 ± 0.006 | 0.272 ± 0.105 | 0.163 ± 0.014 | 0.784 ± 0.072 | 0.018 ± 0.005 |
| 只用任务 | 0.764 ± 0.172 | 0.026 ± 0.004 | 0.250 ± 0.031 | 0.157 ± 0.021 | 0.679 ± 0.131 | 0.022 ± 0.004 |
| 固定 1:1 | 0.868 ± 0.107 | 0.029 ± 0.008 | 0.297 ± 0.029 | 0.165 ± 0.028 | 0.701 ± 0.106 | 0.023 ± 0.002 |
第 7 步:奖励、接触先验与观测
xhand/mdp/rewards.py,xhand/mdp/observations.py,权重 xarm_xhand_env_cfg.py:62-81,论文附录 B 表 8
关键公式
记 \(\operatorname{mse}(z)=\|z\|_2^2/m\)(m 为 z 的维数)。\(e^p_t\) 是所有物体的位置误差拼成的向量,\(\bar\theta_t\) 是各物体旋转误差的平均,\(e^a_t,e^f_t\) 是臂、手指的关节误差:
- L = 10:XHand 的连杆组数;\(c_{t,o,\ell}\):仿真中连杆 ℓ 是否接触物体 o;\(c^{\text{ref}}\):参考标注。
- \(\mathcal L_t\):仿真和参考都有接触的连杆;\(d^2_{t,\ell}\):这些连杆在物体坐标系下的接触点与标注点的平方距离,对相关物体取平均。
- \(v_j\):臂、手指的关节速度与加速度,物体的线、角速度与加速度,共 8 项;权重 \(w_j\):速度项 1、1、1、0.1,加速度项 10、10、100、10。加速度用相邻控制步的速度差分。
- 代码在 (C17)–(C20) 之外还要乘以 dt(第 6 步)。所有权重与附录表 8 一致。
要点
- 仿真接触怎样判定。每个连杆一个接触传感器,只对目标物体过滤;某物体的接触位置为有限值即视为接触。
rewards.py:299-309,observations.py:214-236 - 只奖励真阳性。参考没有接触而仿真接触了,不扣分。代码与表 8 一致;正文"奖励与参考接触事件一致"的说法更宽。
rewards.py:308 - 接触先验的消融。去掉 \(r_{\text{contact}}\) 后进度 0.861、F1 0.699;去掉 \(r_{\text{dist}}\) 后进度 0.868、接触点误差 0.023 m(见下表)。
- 观测。执行器和 critic 的观测项完全相同:全部关节角与角速度,物体位姿与速度,仿真接触标志,当前帧与未来 5 帧的参考关节和物体位姿,参考接触标志,相位 f/(T − 1)。执行器可选观测延迟和高斯噪声,默认都是 0。
xarm_xhand_env_cfg.py:57-59, 457-500。论文附录 C 说执行器只看带延迟和噪声的位姿与速度,未来参考、接触和相位只给 critic。
| 变体(论文表 6) | 进度 ↑ | 物体位置 (m) ↓ | 物体旋转 (rad) ↓ | 手指误差 (rad) ↓ | 接触 F1 ↑ | 接触点 (m) ↓ |
|---|---|---|---|---|---|---|
| 完整(ConTrack) | 0.899 ± 0.195 | 0.026 ± 0.006 | 0.272 ± 0.105 | 0.163 ± 0.014 | 0.784 ± 0.072 | 0.018 ± 0.005 |
| 去掉接触事件奖励 | 0.861 ± 0.173 | 0.032 ± 0.010 | 0.320 ± 0.044 | 0.168 ± 0.019 | 0.699 ± 0.092 | 0.020 ± 0.005 |
| 去掉接触距离奖励 | 0.868 ± 0.057 | 0.032 ± 0.011 | 0.288 ± 0.071 | 0.149 ± 0.016 | 0.753 ± 0.089 | 0.023 ± 0.005 |
第 8 步:评估协议与训练预算
xhand/__init__.py:22-30,xarm_xhand_env_cfg.py:527-533, 669-673,xhand/mdp/state.py:600-655
整体流程
- 评估一律从第一帧开始;阈值固定为 0.10 m、1.00 rad;到达末帧算成功。论文 4.2
- 指标:成功率;进度 (B12);物体位置、旋转误差在终止前取平均(论文式 11);臂、手指关节平均绝对误差;接触事件对所有帧和所有"连杆–物体"对汇总混淆矩阵后算 F1;匹配接触的接触点误差。论文 4.3
- O:物体数;τ:终止帧。
- \(N_{\text{env}}=8000\) 取自 README 的 XHand 训练命令;论文附录 F 给出 5.6–6.4×10⁸ 步,(C22) 正好是上端。推算
要点
- 代码里的评估起点。Play 任务
Isaac-Xarm-Xhand-Mimic-Manager-Play-v0用reset_reference_episode_first_frame,写入 \(B[0]\),即参考第 0 帧的状态与差分速度。它不更新阈值课程,阈值保持初值 0.10 m、1.0 rad,与论文一致。代码 - 没有指标脚本。
scripts/rsl_rl/play.py只跑策略、录视频;仓库里没有计算进度、F1、接触点误差的代码。 - 训练时长。论文每片段 5000 次更新,单张 RTX 4090 约 1.9–2.9 小时。附录 F 代码默认
max_iterations = 100_000(rsl_rl_ppo_cfg.py:27),README 命令没有传--max_iterations,照抄会训练 100,000 次。附录 G 的 Ring 长训用的正是 100,000 次。
9. 论文与代码不一致的地方
"论文"包括正文、算法框和附录;"代码"指提交 f5efe18。影响一栏凡属推断均已标注。
| # | 项目 | 论文 | 代码 | 影响 |
|---|---|---|---|---|
| 1 | 库的初值 | 没有说明;正文强调不复制参考状态 | 每一帧先填参考状态与差分速度,未访问的帧和第 0 帧一直是参考状态(state.py:247-295) | 早期与未到达帧的重置仍是参考状态 推断 |
| 2 | 最佳续航 | 算法 2:不衰减的运行最大值 | 每次调用乘 0.99999;第 0 帧永不覆盖(state.py:522-523) | 8 万步后衰减到约 0.45,旧纪录可被较短的续航覆盖 推算 |
| 3 | 平均续航的更新 | 算法 2:每个结束的回合各做一次滑动平均 | 同一批中经过同一帧的回合先平均,再做一次滑动平均(state.py:514-521) | 有效平滑窗口随并行环境数变化 推断 |
| 4 | 起点采样 | 正文与算法 2 只有 p(k) ∝ exp(−uk/τ);附录 D 补充 50% 的边界分支 | 边界 = 向后差分最大的 64 处(只取正向跳升),并强制包含第 0 帧(state.py:555-567) | 起点的集中主要来自边界分支 推导 |
| 5 | 任务回报估计 | 算法 1 第 3 行:折扣回报 | 不打折扣的回合累计,且已乘 dt(ppo.py:183-190) | 回合长度随起点变化,\(\hat J_g\) 受起点分布影响 推断 |
| 6 | \(J_g^\star\) | 算法 1:全程最大值;附录 D:最近 20 次更新的最大值 | 最近 20 次更新的最大值(ppo.py:135, 241-242) | 论文内部不一致,代码随附录 |
| 7 | 优势混合 | 式 (5):三路优势,惩罚权重为 1 | 两路(惩罚并入两路),各自标准化后再混合(ppo.py:194, 340;rollout_storage.py:154-157) | 标准化后 w 不再严格等于奖励权重 推断 |
| 8 | 执行器观测 | 附录 C:只有带延迟、带噪声的位姿与速度 | 与 critic 相同,含未来 5 帧参考、接触标志、相位;延迟和噪声默认为 0(env_cfg:57-59, 461-482) | 开源策略不是论文描述的非对称结构 |
| 9 | 训练时的终止阈值 | 只给出评估阈值 0.10 m、1.00 rad | 按成功率收紧到 0.05 m、0.5 rad(state.py:469-494;env_cfg:84-90) | 训练终止比评估严格 |
| 10 | 动作 | \(q^{\text{tar}}=q^{\text{ref}}+a\) | a 截到 [−1, 1],乘以 0.01 rad(臂)、0.25 rad(手指)(actions.py:280-287) | 臂的修正幅度很小 |
| 11 | 训练时长 | 每片段 5000 次更新 | 默认 100,000 次,README 命令未覆盖(rsl_rl_ppo_cfg.py:27) | 照 README 复现会多训 20 倍 |
| 12 | λ 预热 | 没有提到 | 可选预热:前 N 次 λ = 20、w = 1;默认 N = 0(ppo.py:231-236) | 默认不生效 |
| 13 | 旋转误差 | \(2\arccos(\bar q^\top\bar q^{\text{ref}})\) | \(2\arccos|\bar q^\top\bar q^{\text{ref}}|\)(terminations.py:25-30) | 代码对四元数符号不敏感,属正确写法 |
| 14 | 图 4 与表 4 | 图 4 中 α = 0.9 为 (0.945, 0.850),固定 100%、50% 为 0.925、0.882 | — | 与表 2、表 4 的 0.899/0.784、0.764、0.868 不同,论文内部不一致 |
此外,环境配置里域随机化(物体 xy 扰动、PD 增益)默认关闭(env_cfg:54-56),论文附录没有列出训练时的随机化范围。
10. Sharpa 版与 XHand 版的差异
对比 mimic_rby1a_sharpa/mdp/state.py 与 mimic_xarm_xhand/mdp/state.py。代码
- 重置库完全相同。五个常数相同(
sharpa state.py:37-41);把资产名和维度统一替换后,写入与采样的代码逐行一致。 - 维度。每只手 29 个关节(7 臂 + 22 指),XHand 是 19 个(7 + 12);库中每只手存 58 维而不是 38 维(
sharpa state.py:365)。 - 一个关节体装两侧。RB-Y1A 的两条臂和两只 Sharpa 手在同一个关节体
rby1a_sharpa里。单手片段时,另一侧的关节在每次重置(包括评估重置)时写回默认姿态、速度为 0(sharpa state.py:413-427, 674-681, 746-753),并在启动时关闭那一侧的碰撞(rby1a_sharpa_env_cfg.py:110, 523-524)。XHand 版两侧是两个独立关节体,片段里没有的一侧不加载。 - 自碰撞过滤。启动时给 Sharpa 手掌与指根之间的若干连杆对设置碰撞过滤(
sharpa state.py:43-108)。 - 其余相同。奖励公式、接触连杆分组(10 组)、PPO 与对偶权重配置相同;Sharpa 的 PPO 配置只改了存档间隔和实验名。README 中 Sharpa 用 6000 个环境,XHand 用 8000 个。
- 结果。Sharpa 平均进度 0.929、接触 F1 0.777;DexterHand 一档 0.998,高于 XHand 的 0.733。附录表 7