做动作跟踪时,每个回合都要先决定一件事:机器人从参考动作的哪一帧开始? 这就是重置采样(reset sampling)。
如果总从第一帧开始,机器人早早摔倒,后面的动作几乎练不到。如果均匀地随机挑帧,已经学会的动作又在反复占用训练量。所以常见做法是:记录每一段动作现在做得怎么样,做得差的多抽。
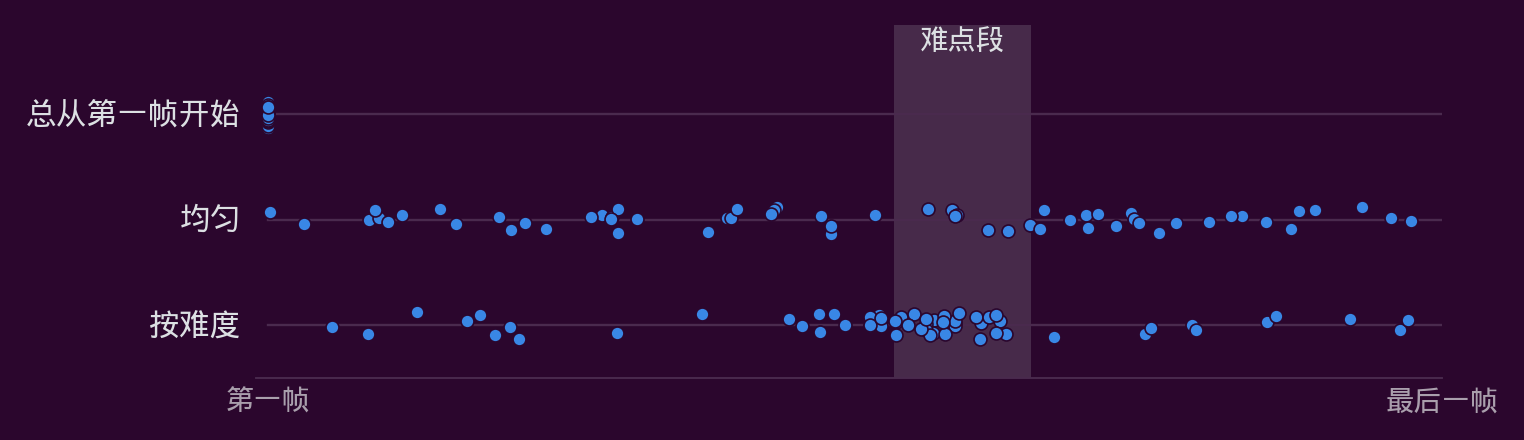
这篇对照三份材料讲清楚这件事:SuperMimic 的公开复现(dhmbb2/supermimic_vibe)的代码、灵巧手跟踪论文 ConTrack,以及 SGS。
SuperMimic:按回报采样
SuperMimic 论文把这一步叫 return-based reset sampling,代码在 sim_env.py 里,分四步。
第 1 步:切段。 把整个动作库按 1 秒切成小段(bin),LAFAN1 约 8,800 段。每段
第 2 步:打分。 一个回合结束时(摔倒、片段放完或超时),算出这回合的折扣回报,除以”同样长度下能拿到的最大折扣回报”,得到 0 到 1 之间的比值。摔倒之后的帧不再得分,所以摔得越早,比值越低。然后更新这回合起点所在的那一段:
第一次访问时直接取这个比值。
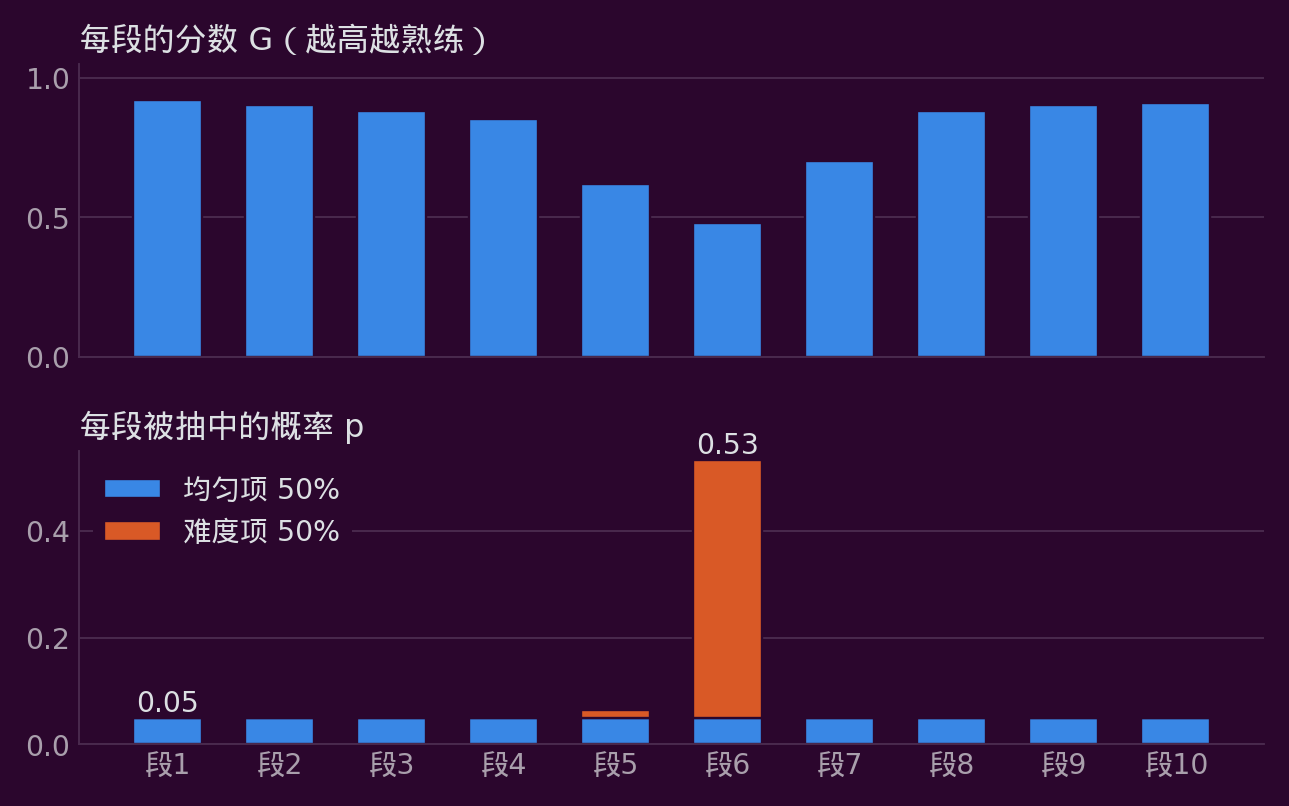
第 3 步:算概率。 每次重置,每一段被抽中的概率由三部分混合:
其中
- 50% 均匀:所有动作都保持练习。
- 40% 偏向低分段:
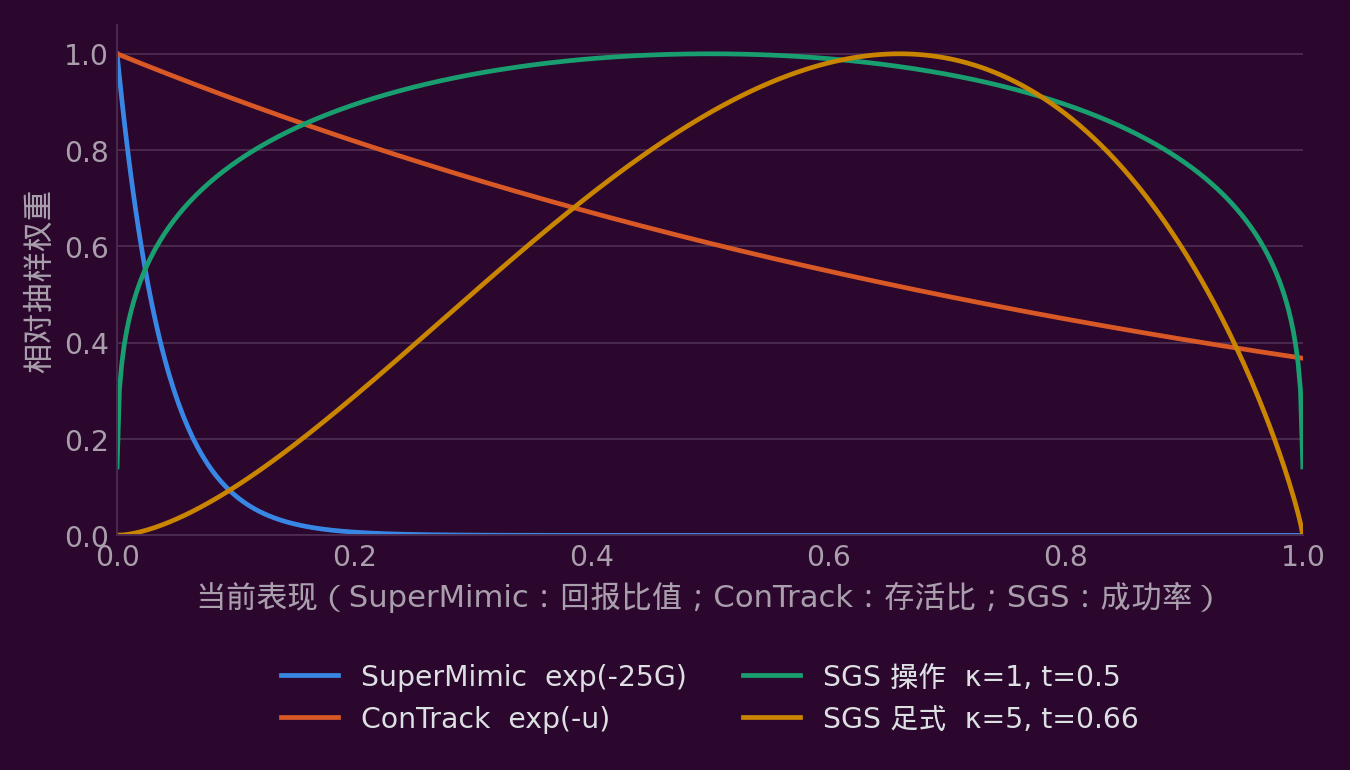
就是”当前最难的段”。系数 25 很陡:分数低 0.1,权重就大约 12 倍。例如三段分别 0.9、0.8、0.5, 约为 0.00005、0.0006、0.9994,几乎全压在最差的一段上。 - 10% 偏向过去难的段:
每次更新为 。一段学会后 掉下来,但 只缓慢衰减,这段还会被练一阵,不至于学完就忘。
还有一个顺带的效果:没访问过的段
第 4 步:抽帧。 按
1 | # sim_env.py:_sample_start_frames 与回合结束时的更新(简化) |
ConTrack:不只选帧,还存下能到达的状态
ConTrack 做的是手和物体的跟踪,思路相同,但有两点不同。
不用回报,用”能撑多久”。 库按帧组织,帧
论文取
不重置到参考状态,重置到策略真实到过的状态。 人形动作跟踪可以直接把机器人摆成参考姿态;手和物体不行,参考里的接触关系在仿真里可能根本不成立,直接摆上去就救不回来。所以 ConTrack 给每一帧缓存一个仿真状态:某次回合经过这帧、并且比之前撑得更久时,就用当时的状态覆盖缓存。重置时读这个状态。
SGS:太难的也少练
SGS(Success-Guided Sampling,论文,CoRL 2026)不做动作跟踪,做的是足式越障和接触丰富的装配,但问题相同:下一回合从哪开始。
它在训练前固定
其中
和前两种的关键区别: SuperMimic 和 ConTrack 都是”越差越多抽”;SGS 抽得最多的是中等成功率,从来没成功过的配置反而少抽,因为这种数据没有可学的梯度信号。项目主页给了一个例子:UR5e 拧螺母的某个配置,一直失败时权重只有峰值的 0.14,成功率 42% 时升到 0.99,92% 时回落到 0.73。
三者对比
| SuperMimic(dhmbb2) | ConTrack | SGS | |
|---|---|---|---|
| 粒度 | 1 秒一段,跨全部片段 | 单条片段内每一帧 | 预先固定的 |
| 难度指标 | 折扣回报比值 | 存活比 | 最近 100 次的成功率 |
| 最常抽 | 分数最低的段 | 存活比最低的帧 | 成功率中等的配置 |
| 重置到 | 参考姿态加小扰动 | 策略到达过的仿真状态 | 配置里的初始状态 |
| 防止过度集中 | 50% 均匀 + 10% 历史难度 | 温度 |
两头都压低,但概率不为 0 |
实验效果
ConTrack:论文表 5 在相同训练预算下比较三种重置方式,进度(Progress)越高越好。自适应重置库明显更高。
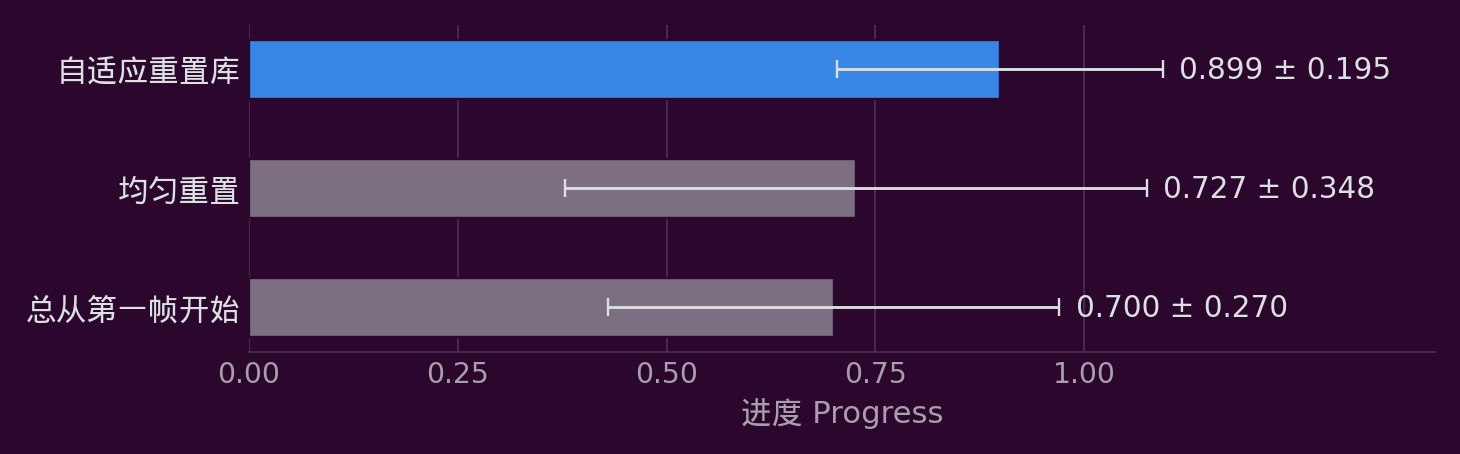
论文还观察到:训练早期重置集中在片段后部,随着策略变强,重置点逐渐往前移。
dhmbb2 的 SuperMimic 复现没有做”开/关采样器”的对比,所以这里没有收益数字;但它记录了一次值得注意的失败:
- LAFAN1 上约 8,800 段都学得会,采样器没有副作用。
- BONES-SEED 有 128,904 条片段,里面有不少机器人做不出的动作。等所有段都访问过后,
开始压向最低分的段:到 10.8 万次迭代,约 180 段几乎不可能完成的动作,占了全部重置的 27%。 - 这次全量运行随后崩塌:评估回报从 0.914 掉到 0.759。
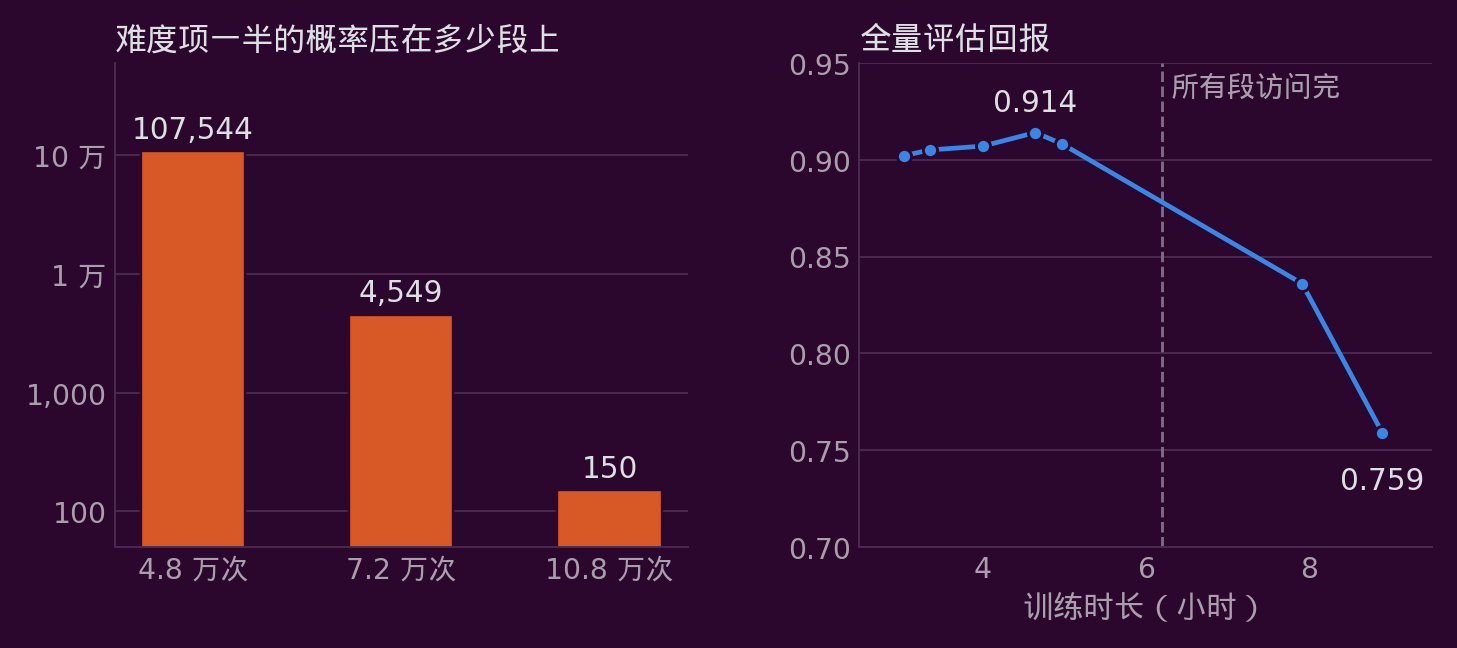
- 作者后来修正了归因:采样器集中会污染训练数据、拉低训练回报,但评估下降还有另一个原因,即确定性闭环偏离了带噪声的训练数据。让一部分环境不加动作噪声后,评估不再下降。
- 作者还试了”回合经过的每一段都更新分数”(更贴近论文原话)。其中一个版本确实不再过度集中,但评估回报依然下降,所以这个改法没有解决问题。
SGS:效果最突出的是并行规模。下图是项目主页的数据,三个随机种子的均值和 95% 置信区间。在 100 万个并行环境下,足式 ANYmal D 全地形 SGS 0.73,PLR 0.54,均匀采样和线性课程都是 0;Franka 拧螺母 SGS 0.70,均匀 0.06,PLR 0.05。
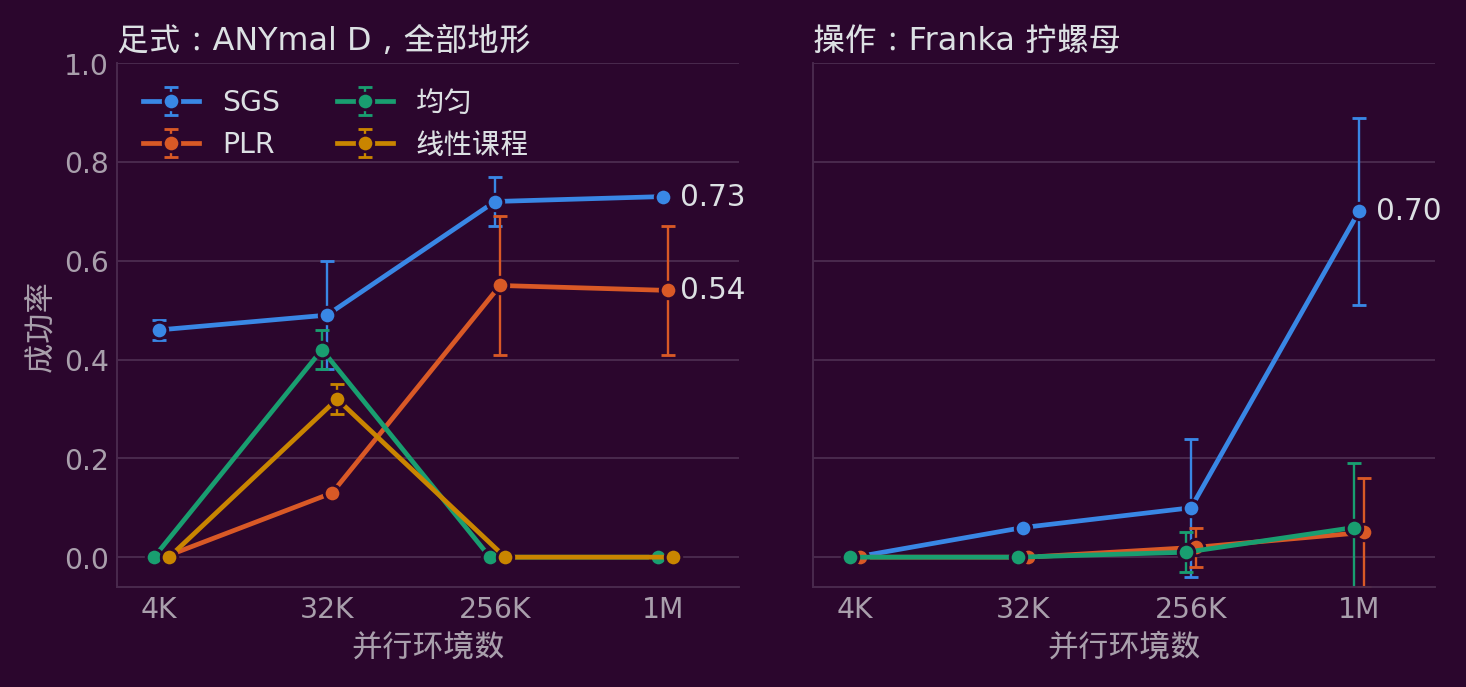
注意操作任务上 SGS 在 25.6 万环境时也只有 0.10 ± 0.14,优势要到 100 万才明显。均匀采样在足式任务上反而随规模崩到 0。论文的解释是:大量环境落在已经学会或完全学不会的配置上,规模越大,这部分浪费越多。另外,这些数字来自作者的论文和主页,代码尚未公开(主页写着 coming soon)。
小结
好处:
- 训练量花在刀刃上:同样的预算,更多地练还没学会的部分。
- 长片段能学完:不必每次都从头走到难点。
- 难度分布随策略自动变化:不用人工排课程表。
- 并行规模用得上:SGS 的结果显示,环境越多,选对配置带来的收益越大。
要注意的:
- 越陡越怕做不到的动作。数据里有不可能完成的动作时,”越差越多抽”会把训练量都吸过去,需要均匀项兜底,或者事先过滤数据。SGS 这种把太难的也压低的权重,从形状上正好避开这个问题,但这只是我的推断:没有公开实验把它用在 SuperMimic 上。
- 训练回报会失真。起点分布一直在变,训练回报下降不一定是策略变差,要看固定起点的评估。ConTrack 也是训练用自己的重置方式,评估一律从第一帧开始。
- SGS 需要成败信号。它依赖每个配置的二值结果。用到动作跟踪上,要先定义什么算成功,还要决定配置怎么划分。
- 接触任务不能直接重置到参考。有物体、有接触时,要考虑 ConTrack 这样重置到真实到达过的状态。